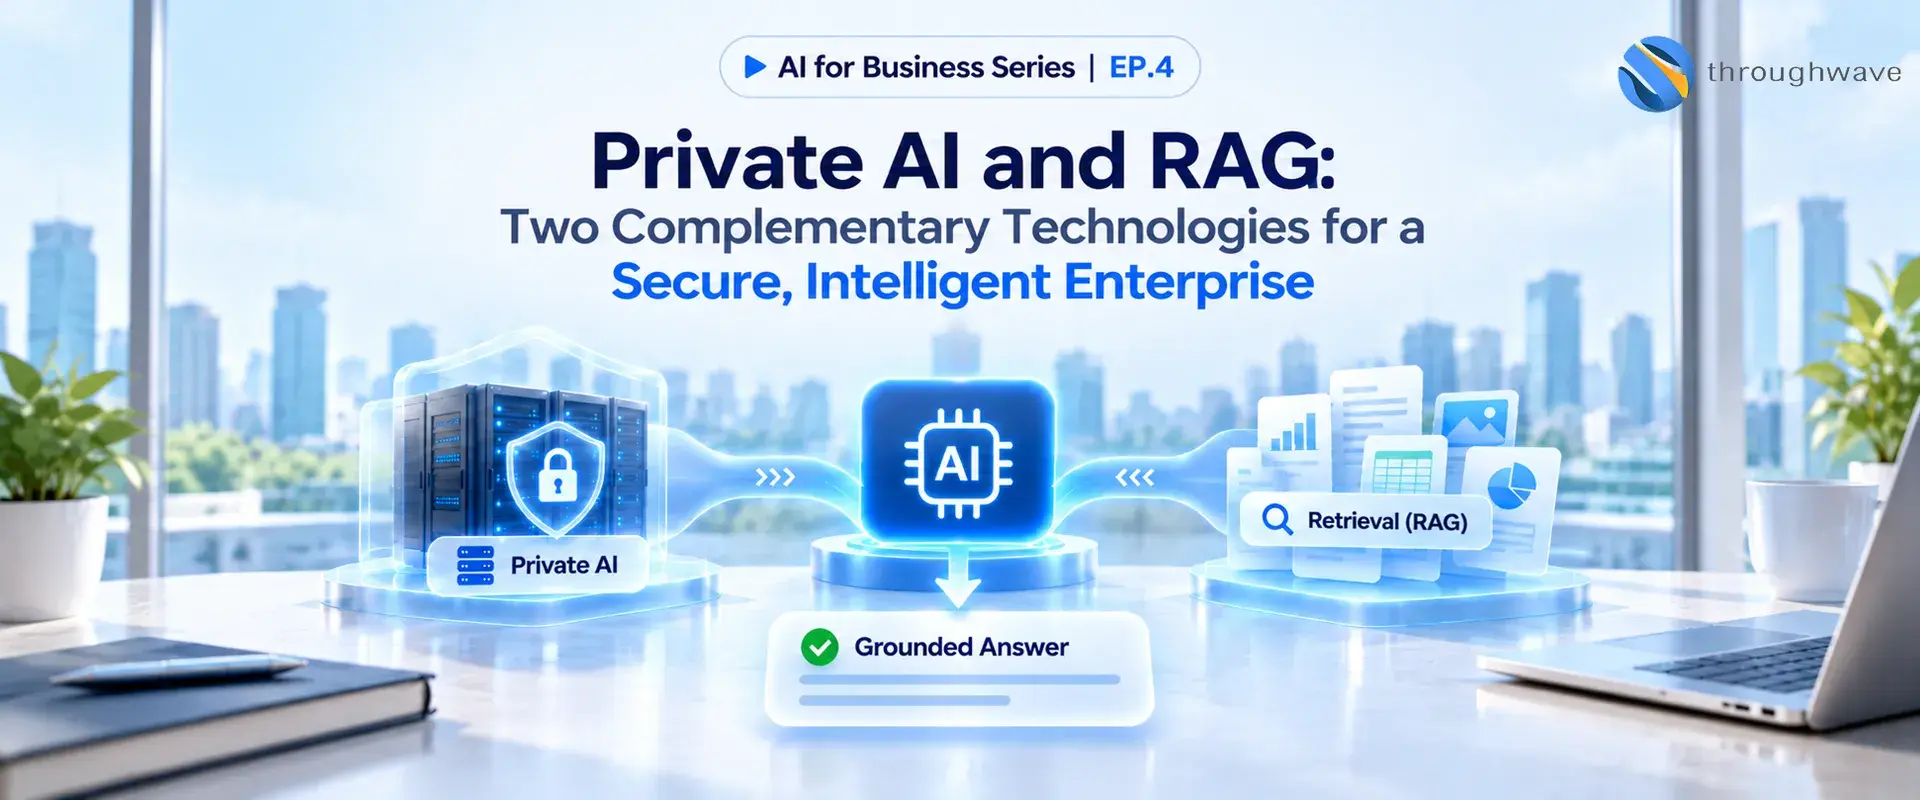
AI for Business Series | EP.4 — Private AI และ RAG: สองขั้วเทคโนโลยีที่ต้องผสานเพื่อความปลอดภัยและอัจฉริยะขององค์กร
ก้าวข้ามความสับสน: Private AI และ RAG ไม่ใช่เรื่องเดียวกัน
เมื่อองค์กรเริ่มวางแผนกลยุทธ์ AI เรามักจะได้ยินคำศัพท์สองคำนี้อยู่เสมอคือ Private AI และ RAG จนบางครั้งเกิดความเข้าใจที่คลาดเคลื่อนว่าสิ่งหนึ่งคืออีกสิ่งหนึ่ง หรือหากมีอย่างใดอย่างหนึ่งแล้วจะครอบคลุมทุกความต้องการ
ความเป็นจริงคือ Private AI และ RAG ตอบโจทย์คนละมิติ และการออกแบบระบบ Enterprise AI ที่มีประสิทธิภาพมักต้องการการผสานพลังของทั้งสองแนวคิดเข้าด้วยกัน
ในตอนนี้ เราจะเจาะลึกความแตกต่างเชิงโครงสร้าง เพื่อให้องค์กรสามารถเลือกใช้ Architecture ที่เหมาะสมกับระดับความเสี่ยงของข้อมูลและงบประมาณ (CAPEX/OPEX) ได้อย่างแม่นยำ
Private AI: นิยามของการ "ควบคุม" (Control & Sovereignty)
คำว่า Private AI ในระดับองค์กร ไม่ได้หมายถึงเพียงการติดตั้งเซิร์ฟเวอร์ไว้ภายในบริษัท (On-premises) เสมอไป แต่มันคือ ระดับของอำนาจในการควบคุม (Degree of Control) ที่องค์กรมีต่อระบบ AI ในมิติต่างๆ ดังนี้:
- Data Sovereignty: ข้อมูลถูกประมวลผลและจัดเก็บที่ใด? อยู่ภายใต้กฎหมายคุ้มครองข้อมูลของพื้นที่ใด?
- Infrastructure Control: เราสามารถกำหนดประสิทธิภาพและความปลอดภัยของฮาร์ดแวร์ได้เพียงใด?
- Security & Privacy: ระบบการเข้าถึง (Access Control) และการเก็บ Log เป็นไปตามนโยบายขององค์กรหรือไม่?
- Data Retention: ข้อมูลที่ส่งให้ AI จะถูกนำไปใช้ฝึกโมเดลของผู้ให้บริการภายนอกหรือไม่?
ดังนั้น Private AI อาจเป็นได้ตั้งแต่การใช้ Private Cloud ที่มีการรักษาความปลอดภัยระดับสูง, การวางระบบใน Virtual Private Cloud (VPC), ไปจนถึงการติดตั้งแบบ Air-gapped ใน Data Center ของตนเอง
หลักการสำคัญคือ: Private AI ตอบโจทย์เรื่อง "ความเชื่อมั่นและความปลอดภัยของโครงสร้างพื้นฐาน"
RAG: กลไกการ "เสริมสร้างปัญญา" (Knowledge Augmentation)
ในขณะที่ Private AI เน้นการควบคุมสภาพแวดล้อม RAG (Retrieval-Augmented Generation) เน้นการเชื่อมโยง AI เข้ากับ "คลังความรู้" ขององค์กร โดยทำหน้าที่ค้นคืนข้อมูลที่เกี่ยวข้องมาเป็นบริบท (Context) ให้กับโมเดลในขณะประมวลผลคำถาม
จุดเด่นของ RAG คือ:
- ไม่ต้อง Training โมเดลใหม่ ซึ่งใช้ต้นทุนสูงและใช้เวลานาน
- ข้อมูลอ้างอิงเป็นปัจจุบันเสมอ เพียงแค่เราอัปเดต Knowledge Base
- ลดโอกาสเกิดข้อมูลเท็จ (Hallucination) เพราะ AI ต้องตอบโดยอ้างอิงจากเอกสารที่กำหนด
หลักการสำคัญคือ: RAG ตอบโจทย์เรื่อง "ความแม่นยำและความฉลาดในบริบทของธุรกิจ"
ความสัมพันธ์เชิงสถาปัตยกรรม: เปรียบเทียบ 4 รูปแบบการนำไปใช้
ความเข้าใจผิดที่ว่า "มี RAG เท่ากับมี Private AI" อาจนำไปสู่ความเสี่ยงได้ ลองพิจารณาสถานการณ์เหล่านี้:
- มี RAG แต่ไม่ใช่ Private AI: องค์กรดึงข้อมูลภายในมาเป็นบริบท แต่ส่งข้อมูลนั้นไปประมวลผลผ่าน Public AI Service ภายนอก (หากไม่มีข้อตกลงความเป็นส่วนตัวที่รัดกุม ข้อมูลสำคัญอาจรั่วไหลได้)
- เป็น Private AI แต่ไม่มี RAG: องค์กรติดตั้งโมเดลในเซิร์ฟเวอร์ตัวเองอย่างปลอดภัย แต่โมเดลไม่มีข้อมูลภายในบริษัทเลย (AI จะปลอดภัยมากแต่ตอบคำถามเกี่ยวกับธุรกิจคุณไม่ได้)
- ไม่มีทั้งคู่: ใช้ AI ทั่วไปประมวลผลข้อมูลทั่วไป (เหมาะกับงาน Public ทั่วไป แต่ไม่เหมาะกับงาน Enterprise)
- Private AI + RAG: แนวทางที่สมบูรณ์ที่สุดสำหรับองค์กร คือการมีทั้งสภาพแวดล้อมที่ควบคุมได้ และมีการเชื่อมต่อกับฐานข้อมูลภายในอย่างเป็นระบบ
RAG: ประตูบานแรกสู่การทำ Private AI ที่คุ้มค่า
สำหรับองค์กรส่วนใหญ่ การเริ่มต้นด้วย RAG มักเป็นกลยุทธ์ที่ให้ผลตอบแทนคุ้มค่าและรวดเร็ว (Low Risk, High Value) เพราะ:
- Agility: ปรับตัวได้เร็ว ข้อมูลเปลี่ยนแค่เปลี่ยนไฟล์ Index ไม่ต้องเริ่มฝึกโมเดลใหม่
- Traceability: แสดงแหล่งอ้างอิงได้ทันที สร้างความเชื่อมั่นให้ผู้ใช้งาน
- Granular Access Control: สามารถกำหนดสิทธิ์การเข้าถึงข้อมูลได้ตั้งแต่ขั้นตอนการค้นหา (Retrieval Level) ซึ่งทำได้ยากกว่าในโมเดลที่ผ่านการ Fine-tune
- Foundation for Future: งานเตรียมข้อมูล (Data Prep) ที่ทำในขั้น RAG จะกลายเป็นสินทรัพย์สำคัญหากวันหนึ่งองค์กรต้องการทำ Custom Model ของตัวเอง
เมื่อไหร่ที่ควรขยับจาก RAG ไปสู่ Local Private AI หรือ Custom Model?
การตัดสินใจย้ายระบบประมวลผลมาสู่ภายในองค์กร (Local Deployment) หรือการทำโมเดลเฉพาะทาง ควรเกิดจากความจำเป็นทางธุรกิจที่วัดผลได้:
| สัญญาณเตือน | ความหมายเชิงธุรกิจ | แนวทางการปรับเปลี่ยน |
|---|---|---|
| ความอ่อนไหวของข้อมูลสูงมาก | ติดข้อกำหนดทางกฎหมายหรือ PDPA ขั้นรุนแรง | ย้ายไปใช้ Local / Private LLM |
| ต้นทุน API พุ่งสูง | ปริมาณการใช้งานสูงจน OPEX เกินงบที่ควรจะเป็น | พิจารณา Local LLM เพื่อเปลี่ยนเป็น CAPEX |
| Latency ต่ำเป็นพิเศษ | ต้องการการตอบสนองแบบ Real-time หน้างาน | ใช้โมเดลขนาดเล็กแบบ Quantized บน Edge / On-prem |
| ต้องการความเข้าใจศัพท์เฉพาะทางสูง | RAG ดีแล้วแต่ AI ยังสรุปผลผิดพลาด (EP.3) | ทำ Fine-tuning ด้วยข้อมูลที่ติด Label คุณภาพ (EP.2) |
| Vendor Lock-in | ต้องการอิสระจากการผูกขาดของผู้ให้บริการรายเดียว | เลือกใช้ Open-weight Models บนระบบควบคุมเอง |
กลยุทธ์การเติบโตแบบก้าวหน้า (Phased Approach)
แทนที่จะทุ่มงบประมาณก้อนใหญ่ในวันแรก องค์กรควรเติบโตเป็นขั้น:
1. เฟสเริ่มต้น: RAG บน Enterprise Cloud AI เพื่อพิสูจน์คุณค่า (PoC)
2. เฟสขยายผล: ขยับมาเป็น RAG บน Private Cloud หรือ Local LLM เมื่อมีข้อมูลอ่อนไหวมากขึ้น
3. เฟสเพิ่มประสิทธิภาพ: ทำ Fine-tuning เฉพาะจุดเพื่อเพิ่มความแม่นยำในงานเฉพาะทาง
4. เฟสเชี่ยวชาญ: พัฒนา Custom Model สำหรับข้อมูลที่ไม่ใช่ข้อความ เช่น เสียง, ภาพ หรือ Sensor (EP.1)
การเติบโตแบบนี้ช่วยให้องค์กรสะสมทักษะ (Skillset) และสินทรัพย์ข้อมูล (Data Asset) ไปพร้อมๆ กับการสร้าง Business Value โดยไม่ต้องแบกรับความเสี่ยงเกินความจำเป็น
บทสรุปเชิงยุทธศาสตร์
การเลือก Architecture ไม่ใช่เรื่องของการเลือกว่าเทคโนโลยีไหนดีกว่ากัน แต่เป็นการเลือก "ระดับความเสถียร ความปลอดภัย และความฉลาด" ให้เหมาะกับแต่ละ Use Case
หากองค์กรของคุณกำลังมองหาจุดสมดุลระหว่างความล้ำสมัยและความปลอดภัย Throughwave พร้อมช่วยออกแบบ AI Infrastructure ที่ยืดหยุ่น ตั้งแต่การเลือกใช้ Open-source Model ที่มีประสิทธิภาพสูง, การประเมินขนาดฮาร์ดแวร์ที่คุ้มค่า (Sizing), ไปจนถึงการวางระบบ Security และ Governance ที่สอดรับกับมาตรฐานสากล
ติดตามต่อใน AI for Business Series | EP.5 AI ที่ดีที่สุด ไม่ใช่ตัวที่แพงที่สุด
ต้องการคำปรึกษาเรื่องการวางระบบ Private AI หรือ RAG ที่เหมาะกับธุรกิจคุณ? ทีมวิศวกรและผู้เชี่ยวชาญจาก Throughwave พร้อมสนับสนุนคุณในการออกแบบสถาปัตยกรรมที่ตอบโจทย์ทั้งประสิทธิภาพและงบประมาณอย่างยั่งยืน
บทความที่เกี่ยวข้อง
AI for Business Series | EP.3 — ทำไม AI ถึงตอบผิด ทั้งที่ใช้โมเดลระดับโลกตัวเดียวกัน?
2/11/2569
AI for Business Series | EP.2 — ก่อนทุ่มงบลงทุน AI เพิ่ม... ลองตอบคำถามเชิงยุทธศาสตร์นี้ก่อน: AI ของคุณกำลังประมวลผลจากฐานข้อมูลใด?
28/10/2569
AI for Business Series | EP.1 — AI รอบรู้ข้อมูลทั้งโลก แต่ "รู้จัก" ธุรกิจของคุณดีพอหรือยัง?
20/10/2569